Описание системы
Обзор
AI-платформа состоит из набора Docker-контейнеров, которые можно развернуть в любой инфраструктуре и масштабировать под необходимую нагрузку.
Архитектура системы
На высоком уровне архитектура AI-платформы включает прикладной слой, серверы моделей, слой данных и инфраструктурный слой.
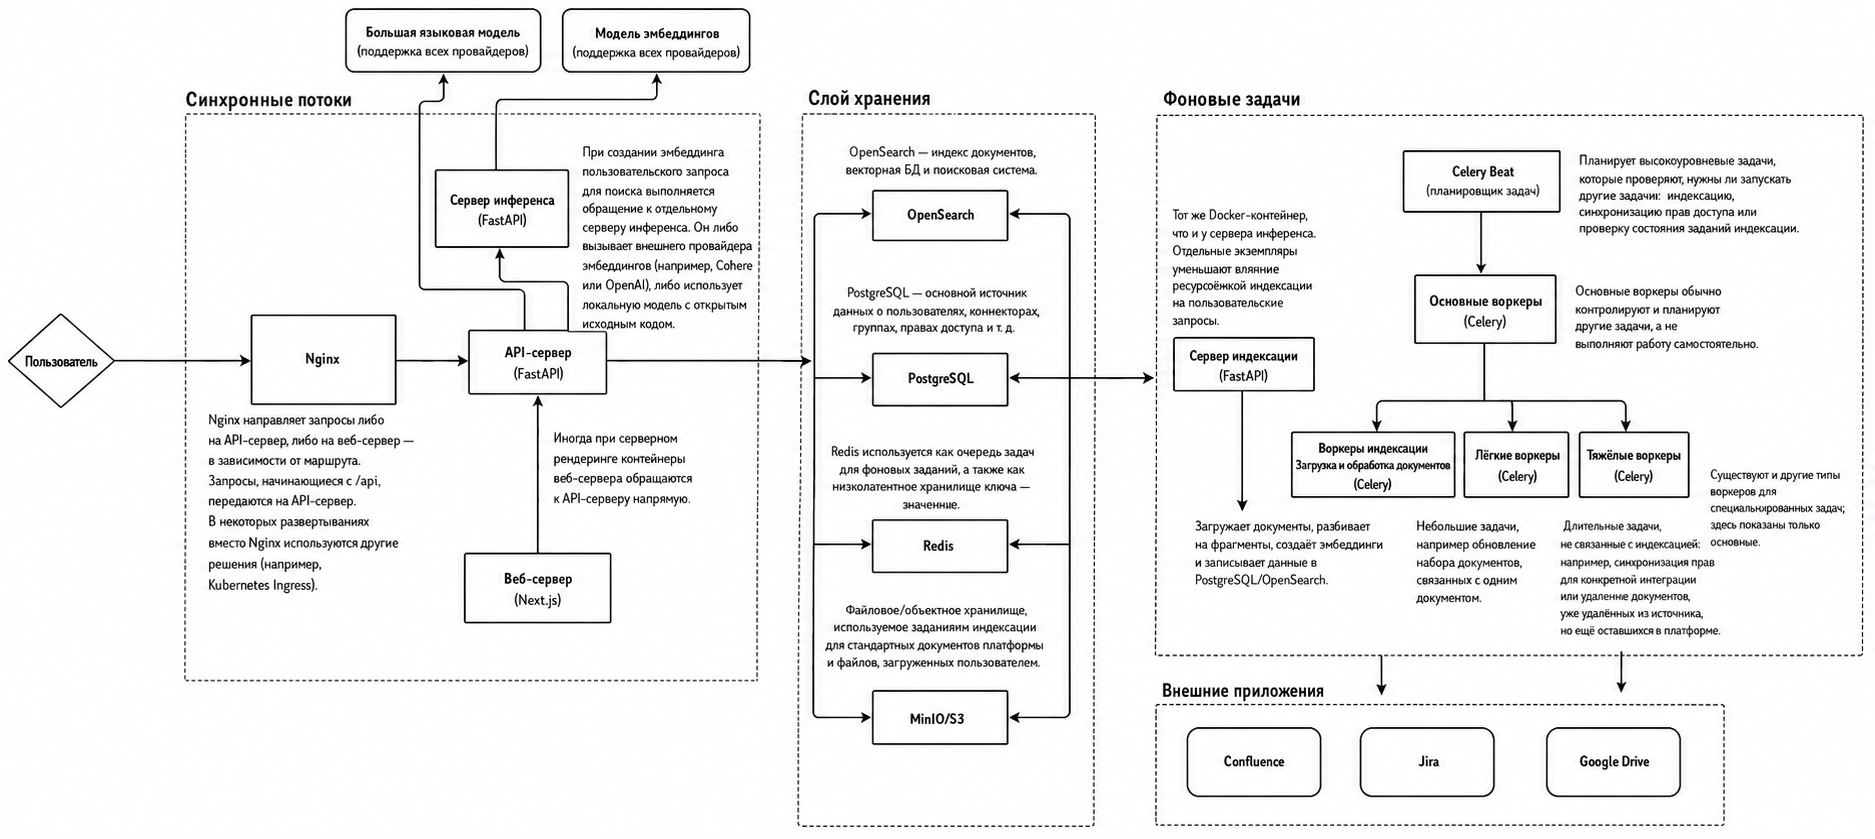
Основные компоненты
Прикладной слой
- Веб-клиент: веб-приложение на базе Next.js, предоставляющее пользовательский интерфейс AI-платформы.
- API-сервер: веб-сервер на Python и FastAPI, обрабатывающий запросы и реализующий бизнес-логику.
- Фоновые обработчики: процессы на Python для выполнения асинхронных задач, например получения обновлений документов.
Серверы моделей
- Сервер моделей для инференса: обслуживает модель эмбеддингов, которая во время выполнения запроса помогает находить релевантный контекст.
- Сервер моделей для индексации: выделенный сервер, создающий эмбеддинги документов во время индексации. Он изолирует ресурсоёмкую индексацию от обработки пользовательских запросов в реальном времени.
Переранжирование
«Переранжирование» здесь — это объединение результатов семантического и полнотекстового поиска средствами OpenSearch.
Процесс выглядит так:
Запрос
  ↓
Embedding запроса
  ↓
Два независимых поиска
  ├─ векторный kNN
  └─ полнотекстовый BM25
  ↓
Нормализация оценок
  ↓
Взвешенное объединение 50/50
  ↓
Сортировка и возврат лучших chunks
1. Строится embedding запроса
Локальная модель nomic-ai/nomic-embed-text-v1 превращает запрос в
768-мерный вектор:
2. OpenSearch параллельно выполняет два поиска
Первый — семантический kNN-поиск по векторам содержимого:
Он находит фрагменты, близкие по смыслу, даже без совпадения конкретных слов.
Второй — полнотекстовый поиск по заголовку и содержимому. Здесь используется стандартная оценка релевантности OpenSearch/BM25:
- обычное совпадение слов в содержимом — вес 1.0;
- совпадение фразы в содержимом — 1.5;
- совпадения в заголовке дают небольшой дополнительный boost — 0.1 или 0.2.
Например, точная фраза «оформление отпуска» получает больше баллов, чем раздельное присутствие слов «отпуск» и «оформление».
3. Собирается расширенный набор кандидатов
По умолчанию каждый подзапрос рассматривает до 500 кандидатов:
Это не обязательно 1000 уникальных фрагментов — результаты могут пересекаться. Расширенный список нужен, чтобы хороший итоговый документ не был потерян слишком рано.
4. Оценки нормализуются
У векторного поиска и BM25 разные шкалы:
Их нельзя корректно сложить напрямую. Поэтому OpenSearch применяет min-max-нормализацию по каждому набору кандидатов:
После неё обе оценки оказываются примерно в диапазоне 0–1.
5. Оценки объединяются
При текущих настройках:
Например:
| Chunk | Семантика | BM25 | Итог |
|---|---|---|---|
| A | 0.95 | 0.30 | 0.625 |
| B | 0.70 | 0.80 | 0.750 |
| C | 0.40 | 1.00 | 0.700 |
Итоговый порядок будет: B → C → A.
Если фрагмент попал только в один подзапрос, отсутствующая составляющая считается нулевой. Поэтому высокое место обычно получают chunks, которые одновременно:
- семантически похожи на вопрос;
- содержат подходящие слова или фразы.
6. Возвращаются лучшие фрагменты
После объединения OpenSearch сортирует chunks по final_score и возвращает
AI-платформе запрошенное количество результатов. Они затем очищаются,
группируются и используются как контекст для LLM.
Слой данных
- Реляционная база данных: Postgres хранит данные приложения, пользовательские сеансы и состояние системы.
- Поисковая система: OpenSearch обеспечивает полнотекстовый поиск по алгоритму BM25 и векторное хранилище для извлечения контекста.
- Кэш в оперативной памяти: Redis используется для повышения производительности.
- Файловое хранилище: объектное хранилище MinIO содержит загруженные пользователями файлы и документы, полученные через коннекторы.
Инфраструктурный слой
- Маршрутизатор запросов: обратный прокси-сервер Nginx выполняет балансировку нагрузки и маршрутизацию запросов.
Замена компонентов
Некоторые компоненты стека AI-платформы заменить сравнительно просто, тогда как замена других потребует значительных изменений.
- MinIO можно заменить на аналогичное объектное хранилище. Интерфейс файлового хранилища абстрагирован, поэтому такая замена не требует существенных доработок.
- Redis можно заменить управляемым сервисом Redis. Использование другого кэша в оперативной памяти возможно, но потребует изменений в коде.
- Postgres можно заменить управляемым сервисом Postgres. Переход на другую реляционную СУБД значительно сложнее и не рекомендуется из-за использования специфичных для Postgres функций и оптимизаций.
- OpenSearch можно заменить многоузловым кластером OpenSearch, хотя обычно в этом нет необходимости, или управляемым сервисом OpenSearch. OpenSearch тесно связан с механизмами извлечения контекста, поэтому переход на другую поисковую систему потребует значительной разработки для сохранения текущей функциональности.
- Nginx можно удалить и заменить собственным прокси-сервером для маршрутизации запросов.